はじめに: セキュリティ製品は、導入しただけでは組織を守れない
- IDS: 侵入検知システム, Intrusion Detection System
- IPS: 侵入防止システム, Intrusion Prevention System
これらは、ネットワークやシステム上の通信・動作を監視し、不正な活動の兆候を検知するための仕組みです。IPS は、検知した通信を遮断するなど、防止動作まで行うことを目的とします。
しかし、検知できることと、被害を防げることは同じではありません。監視対象から外れた通信は見えず、アラートが出ても対応する人や権限がなければ状況は変わりません。さらに、装置の設定や証明書、ログ収集、検知ルールが適切に維持されていなければ、製品を導入していても期待した働きをしないことがあります。
この記事では、近年の検知技術と AI/ML の役割を整理し、最後に経営・管理側が整えるべき運用体制を考えます。
この記事シリーズの要点
- IDS/IPS が検査できるのは、原則として製品が観測できる通信・動作に限られる。
- 検知はインシデント対応の入口であり、調査・判断・封じ込め・復旧までつながって初めて被害を抑えられる。
- AI/ML や高価な監視製品を追加しても、データの不足、誤検知、見逃し、運用能力の不足はなくならない。
- 経営・管理側には、必要な予算・人員・判断権限と、現場が実行できる優先順位を整える役割がある。
1. IDS/IPS は何を検知し、何を防ぐのか
IDS/IPS は、攻撃をすべて止める装置ではありません。監視できる通信や動作について、不審な兆候を見つけ、必要に応じて遮断し、調査に使える情報を残すための防御手段です。
| 機能 | 主な働き | 組織にとっての意味 |
|---|---|---|
| IDS | 不審な通信・動作を検知し、記録・通知する | 攻撃の兆候を把握し、調査や対応を開始する手掛かりになる |
| IPS | 検知した通信を遮断するなど、防止動作を行う | 条件に合致した攻撃の一部を、対象システムへ到達する前に止められる |
| 異常・振る舞い分析 | 通信量、接続先、利用パターン、プロトコルの逸脱などを分析する | 既知の攻撃パターンだけでは捉えにくい活動を調査する手掛かりになる |
| ログ・アラート | 検知内容や関連情報を記録・通知する | インシデント対応、監査、事後検証、検知ルールの改善に利用できる |
IDS と IPS は、必ずしも別々の製品を意味するわけではありません。両方の機能を備える製品もあります。また、ネットワークの通信経路上で動作するネットワーク型だけでなく、個々のサーバーや端末上の動作を監視するホスト型もあります。 IPS の遮断機能を実際に使うには、通信経路上で制御できる構成や、ホスト側で防止動作を実行できる構成が必要です。製品名だけでなく、配置・設定・有効化されている機能を確認しなければなりません。[1]
2. 検知技術は広がったが、死角は残る
シグネチャ照合は、現在も重要な検知方式です。ただし、 IDS/IPS は既知の攻撃パターンだけで動くわけではありません。プロトコルの異常や通信の振る舞いを分析する方式も以前からあり、複数の手法を組み合わせて検知することが一般的です。したがって、検知技術を単純に「従来型のシグネチャ」と「新しい AI/ML」に二分するのは正確ではありません。[1]
| 検知・分析の手法 | どのように判断するか | 強みと限界 |
|---|---|---|
| シグネチャ照合 | 既知の攻撃パターンや特徴と照合する | 既知の脅威を比較的明確に検知できる一方、未登録・変化した攻撃には弱い場合がある |
| プロトコル異常分析 | 通信プロトコルの仕様や通常の利用方法から外れた動きを検知する | 不正な形式や不自然な通信を捉えられるが、正規の手順を悪用した活動は判断しにくい |
| 振る舞い・異常分析 | 通信量、接続先、利用時間、アクセス対象などの通常状態からの逸脱を検知する | 未知の活動の手掛かりになる一方、正常な業務変更も異常と判定することがある |
| ログの相関分析 | 異なるシステムで発生した複数のイベントを時間軸や関係性で結び付ける | 攻撃の一連の動きを把握しやすいが、ログが不足・不整合であれば分析できない |
| 脅威情報との照合 | 公開・共有された不正な IP アドレス、ドメイン、ファイルハッシュなどと照合する | 既知の脅威の手掛かりになるが、情報の鮮度や攻撃者の変化に左右される |
NDR、 EDR、 SIEM、 XDR などは、こうした分析を異なる観測対象や情報源で支援する技術・製品群です。製品によっては機械学習や統計的な分析を使い、単一のシグネチャでは捉えにくい異常を検知します。ただし、 AI/ML がシグネチャやルールベースの検知を全面的に置き換えたわけではありません。
AI/ML や行動分析は検知能力を補う有力な手段ですが、環境の変化やデータの品質に左右されます。監視対象が増えれば自動的に検知が正確になるわけではありません。どの情報を集め、何を正常とみなし、どの変化を重大な兆候として扱うかは、組織の環境に合わせて継続的に調整する必要があります。[3][4]
3. AI/ML を活用しても、見逃しと誤検知がなくならない理由
1. 通常の活動に紛れる「Low-and-Slow」型の攻撃
攻撃者が短時間に大量のデータを持ち出せば、通信量の急増として検知されやすくなります。そこで、活動を長期間に分散し、普段の利用量に近い速度で少しずつデータを取得・送信する手法が使われることがあります。こうした活動は、一般に「Low-and-Slow」型と呼ばれます。
一回ごとの通信だけを見れば異常が小さく、単純な閾値では検知しにくい場合があります。一方、期間をまたいだ利用者の行動、アクセス先、データ取得量などを関連付ければ、異常の兆候を捉えられる可能性があります。重要なのは、単発のアラートだけでなく、時間軸と複数システムを横断した分析です。[3]
2. 正規の認証情報や権限の悪用
攻撃者が盗んだ ID/パスワード、セッショントークン、 API キーなどを使う場合、通信そのものは正規の利用者やシステムから発生したように見えることがあります。
認証に成功したという事実は、その利用者が対象データを閲覧・操作する正当な権限を持つことを保証しません。ネットワーク監視だけでなく、 ID の利用状況、権限、アクセス対象、操作の業務上の妥当性を組み合わせて確認する必要があります。利用者の通常業務から大きく外れる操作を検知するには、システムのログだけでなく、業務や役割についての理解も重要です。[2]
3. 「正常」の基準そのものが間違っている可能性
行動分析では、通常の通信や利用者の振る舞いを基準 (ベースライン) として学習・比較する方法があります。しかし、すでに侵害されている状態を「通常」として学習してしまえば、不正な活動が正常の一部として扱われる可能性があります。
英国の国家サイバーセキュリティセンター (NCSC) は、ベースラインを作る際に、そのシステムがすでに侵害されていないかを考慮するよう注意を促しています。ベースライン比較は有効な手法ですが、無条件に信頼できる基準ではありません。[7]
4. 偽陽性・偽陰性とアラート疲労
異常検知の感度を高くすれば、通常の業務変更、開発テスト、夜間バッチ処理なども警告対象になる場合があります。反対に、誤検知を減らそうとして検知条件を厳しくしすぎると、本物の攻撃の兆候を見逃す可能性があります。
- 偽陽性 (False Positive): 実際には問題がないのに、異常やインシデントとして警告すること。
- 偽陰性 (False Negative): 実際には問題が起きているのに、検知できず警告しないこと。
オーストラリアの公的サイバーセキュリティ機関が 2025 年に公表した SIEM/SOAR 実践ガイダンスは、ログが不完全・不整合である場合や、検知ルールの感度が適切でない場合には偽陰性が生じる一方、ログを過剰に取り込み、ルールやフィルターを適切に調整しなければ偽陽性が大量に発生すると説明しています。偽陽性が多すぎると、担当者が警告を処理しきれず、実際のインシデントへの対応が遅れる「アラート疲労」につながります。[4]
                    アラート疲労の悪循環

       ログの過剰収集・検知ルールの調整不足
                         |
                         v
              偽陽性を含む大量のアラート
                         |
                         v
                 担当者の確認負荷が増大
                         |
                         v
              優先順位付け・調査が形式化
                         |
                         v
               重要な兆候の見落とし・遅延
                         |
                         v
                被害の拡大・復旧コスト増大
                         |
                         +------> 運用がさらに疲弊
この問題は、 AI を導入すれば自動的に解消するものではありません。 NCSC は、アラートを担当者が調査できる量に抑え、複数の兆候を相関させ、検知ルールを定期的に見直し、演習などで検知の有効性を検証することを推奨しています。[3]
4. 高価な製品を増やす前に、検知から対応までの運用を設計する
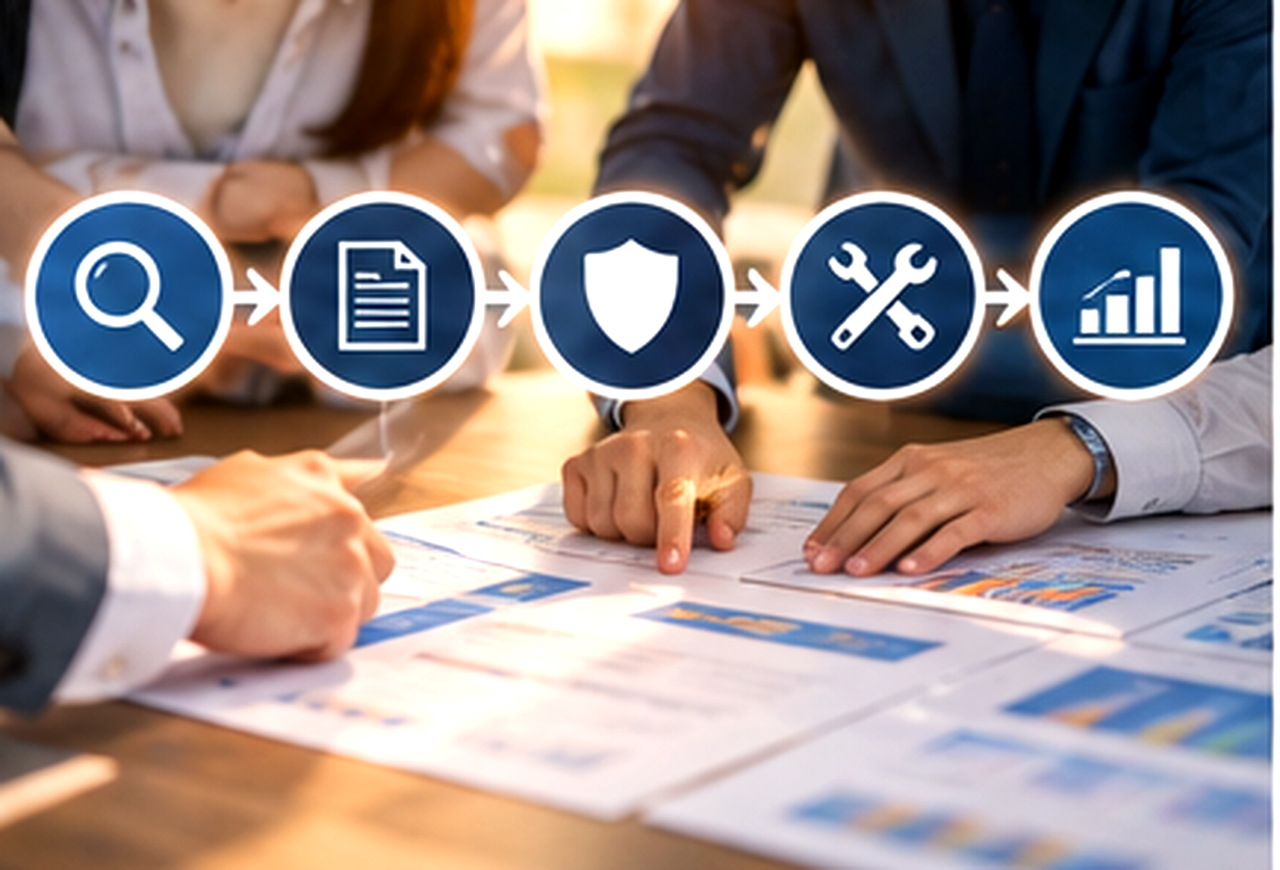
IDS/IPS、 NDR、 EDR、 SIEM などは、それぞれ異なる情報を捉えます。重要なのは、すべての製品を導入することではありません。自組織が守るべき資産と想定する脅威に応じて、必要な情報が集まり、判断・対応につながる仕組みを作ることです。
       通信・端末・ID・クラウド・アプリケーションの情報
                              |
                              v
                    +------------------+
                    | 検知・分析        |
                    | ルール / 相関分析 |
                    +------------------+
                              |
                              v
                    +------------------+
                    | トリアージ        |
                    | 重要度・影響範囲  |
                    +------------------+
                              |
                              v
                    +------------------+
                    | 調査・判断        |
                    | 事実確認・承認    |
                    +------------------+
                              |
                              v
                    +------------------+
                    | 封じ込め・復旧    |
                    | 隔離・遮断・再開  |
                    +------------------+
                              |
                              v
                    +------------------+
                    | 振り返り・改善    |
                    | ルール・手順更新  |
                    +------------------+
                              |
                              +--------> 検知・分析へ反映
検知から対応までを一つの流れとして設計し、各段階の担当者・判断基準・引き継ぎ条件を明確にすることが重要です。
| 運用上の取り組み | 具体的な内容 | 期待する効果 |
|---|---|---|
| 資産の重要度に基づく優先順位付け | 個人情報・決済情報を扱うシステム、重要 API、管理者環境などを特定する | 重要な資産に監視・対応リソースを集中する |
| ログと監視範囲の整備 | ネットワーク、端末、ID、クラウド、アプリケーションの必要なログを選び、取得状況や欠損を定期確認する | 検知の死角や、分析に必要な情報の不足を減らす |
| SIEM の収集対象の選定 | セキュリティ分析に必要なログを優先し、保管・監査を主目的とする大量ログとは役割や保存先を分けて考える | 不要なデータ量やコストを抑え、分析の質を保つ |
| アラートのトリアージ | 重大度、影響資産、攻撃の進行状況、業務への影響などで優先順位を付ける | 重要な警告を先に調査し、対応遅延を減らす |
| 検知ルールの継続的な調整 | 偽陽性・偽陰性を振り返り、ルールの追加・修正・廃止を行う | 環境や脅威の変化に追随する |
| 対応手順と権限の明確化 | 誰が調査し、誰がアカウント停止・端末隔離・ネットワーク遮断・サービス停止を決定するか定める | 検知から封じ込めまでの時間を短縮する |
| 自動化の段階的な活用 | 明確な条件のある定型処理から自動化し、誤動作時の解除・復旧方法を用意する | 人手の負担を減らしつつ、誤った自動遮断による業務影響を抑える |
| 訓練と事後検証 | アラート対応、連絡、封じ込め、復旧を演習で試し、検知ルールも検証する | 手順の不備や責任分界の曖昧さを発見する |
ログを大量に集めれば、分析の精度が必ず上がるわけではありません。 SIEM は、セキュリティ上の事象を見つけるために意味のあるログを選び、適切なルールやフィルターで分析する必要があります。オーストラリアの実践ガイダンスは、 SIEM を単なる全ログ保管場所として利用することによるコストや分析効率の問題にも注意を促しています。[4]
自動化も万能ではありません。誤った判定で正規利用者のアカウントや業務システムを自動隔離すれば、セキュリティ事故とは別の業務障害を引き起こす可能性があります。 SOAR などの自動対応は、組織の環境に合わせて設計・維持する必要があります。オーストラリアのガイダンスは、 SIEM の分析能力や運用経験が成熟していない環境では、 SOAR の導入を急ぐよりも、まずログ分析と検知運用を整えることを優先するよう勧めています。[4]
インシデント対応の計画、役割・権限、手順、訓練は、検知製品の導入とは別に整える必要があります。 NIST の SP 800-61 Rev. 3 も、インシデント対応を個別の技術作業に閉じず、組織全体のサイバーセキュリティリスクマネジメントに組み込む考え方を示しています。[5]
5. 経営者・管理者層が果たすべき役割
高度な IDS/IPS や AI を導入しても、それを運用する人員、判断権限、時間、予算が不足していれば、期待する効果は得られません。セキュリティを現場のエンジニアの努力だけに依存させず、経営・管理側が持続可能な運用条件を整える必要があります。
| 経営・管理側の役割 | 実施すべきこと | 避けるべき状態 |
|---|---|---|
| 優先順位とトレードオフの決定 | 重要資産と事業影響に基づき、対応順序、期限、予算を決める | すべてを最優先とし、通常業務も納期も変えずに追加対策だけを現場へ要求する |
| 対応権限の整備 | 緊急時にネットワーク遮断、アカウント停止、サービス停止を判断できる責任者を定める | 技術担当に責任だけを負わせ、必要な判断権限を与えない |
| 人員・専門性の確保 | 教育、交代要員、外部専門家、マネージドサービスなどを必要に応じて確保する | 特定の担当者だけに監視・調査・対応の知識と作業を集中させる |
| 失敗から学ぶ文化 | インシデントや見逃しの原因を、個人の責任だけでなく仕組み・手順・情報共有から検証する | 報告した人を責め、問題を隠す方が安全だと感じさせる |
| 現場を守る調整役 | 顧客・営業・監査などからの要求をリスク評価に基づいて調整し、現実的なロードマップを提示する | 矛盾する要求や過度なプレッシャーをそのまま現場に押し付ける |
「やらないこと」を決めるのも経営の仕事
セキュリティ対策や監視範囲を拡大すれば、設計・開発・検証・運用に必要な時間も増えます。従来の納期や開発速度を一切変えずに、すべての追加要件を現場へ押し付けることは現実的ではありません。
新しい監視や対応プロセスを導入するなら、経営・管理側は、どの機能や作業の優先度を下げるのか、どのスケジュールを調整するのかを決定する必要があります。現場に「工夫して何とかする」ことだけを求めず、必要なトレードオフを組織として引き受けることが重要です。
アラートの件数ではなく、対応の質を見る
検知したアラートの数を、そのままセキュリティチームの成果として評価するのは適切ではありません。アラート数を増やすことは、必ずしも安全性を高めないからです。
経営・管理側は、次のような指標を組み合わせて、検知と対応が実際に機能しているかを確認するとよいでしょう。
| 指標 | 定義の例 | 確認時の注意 |
|---|---|---|
| MTTD (Mean Time to Detect) | 不審な活動が始まってから、組織が検知するまでの時間 | 攻撃の開始時点を正確に特定できない場合があるため、測定上の起点を定義する |
| MTTA (Mean Time to Acknowledge) | アラート発生から担当者が確認・受領するまでの時間 | 「受領」「調査着手」など、どの時点をもって対応開始とするかを明確にする |
| MTTC (Mean Time to Contain) | 検知から封じ込めまでに要した時間 | インシデントの重大度や対応内容によって単純比較しない |
| 復旧時間 | 業務・システムを許容できる状態に戻すまでの時間 | 封じ込めと復旧を分けて計測する |
| 誤検知・見逃しの傾向 | 不要な警告が多いルール、演習・事後調査で捉えられなかった兆候 | アラート件数だけでなく、調査品質や検知範囲と合わせて見る |
| 監視範囲の充足度 | 重要資産のログや通信が実際に取得され、分析対象になっている割合 | 取得できていることと、適切に分析できていることを分けて確認する |
MTTR という略語は、文脈によって Response、 Resolution、 Recovery など異なる意味で使われます。組織内で利用する場合は、何を起点・終点として測るかを明記し、封じ込め時間や復旧時間と混同しないことが大切です。
数値だけを追うと、調査の質や重大度の違いが見えなくなることがあります。指標は現場を評価・懲罰するためではなく、運用の弱点を発見し、必要な人員や改善投資を決めるために使うべきです。
おわりに: 製品の高度さより、組織として使い続けられること
IDS/IPS は、ネットワーク上の不正な通信や既知の攻撃パターンを検知・遮断するうえで、今も重要な防御手段です。 NDR、 EDR、 SIEM、 AI/ML による分析などを適切に組み合わせれば、観測範囲や検知能力を広げられる場合もあります。
しかし、暗号化された通信、正規の認証情報の悪用、信頼されたソフトウェアや通信に紛れる攻撃、内部ネットワークでの横移動、そして検知後の対応不備といった課題は、製品を新しくするだけでは解決しません。監視装置が正常に動いているか、必要な情報を取得できているか、アラートが適切に処理されるか、侵入後の被害を抑えられるかを継続的に確認する必要があります。
経営者・管理者層の役割は、最新のセキュリティ製品を購入することだけではありません。守るべき資産と事業リスクを把握し、必要な予算・人員・判断権限を用意し、現場が対応できる優先順位と運用体制を整えることです。現場のエンジニアも、技術的な検知・防止だけでなく、何が見えていて何が見えていないのか、どのような対応が必要なのかを組織に伝えることが求められます。
IDS/IPS は「導入すれば守ってくれる装置」ではありません。監視を機能させ、警告を行動につなげ、弱点を継続的に見直す組織の仕組みがあって初めて、その価値を発揮します。
参考資料・出典
- NIST SP 800-94, “Guide to Intrusion Detection and Prevention Systems (IDPS)” (2007 年 2 月) — ネットワーク型、無線型、ネットワーク振る舞い分析型、ホスト型の IDPS の分類と、設計・導入・設定・監視・保守の基礎資料。刊行年が古いため、現在の製品機能を網羅する資料ではなく、基本的な技術分類の参照先として使用。 NIST CSRC
- CISA, “AA20-352A: Advanced Persistent Threat Compromise of Government Agencies, Critical Infrastructure, and Private Sector Organizations” (2020 年 12 月 17 日) — SolarWinds Orion のサプライチェーン侵害、正規のコード署名証明書で署名された不正 DLL、正規の Orion 通信を模倣する通信などを説明。 CISA Advisory
- UK National Cyber Security Centre, “Building a Security Operations Centre (SOC) — Detection practices” — ベースライン比較の限界、複数ログの相関、アラートのトリアージ、偽陽性への対応、検知ルールの継続的な見直し、演習による検証に関するガイダンス。 NCSC
- Australian Signals Directorate / Australian Cyber Security Centre, “Implementing SIEM and SOAR platforms: Practitioner guidance” (2025 年 5 月 27 日) — SIEM のログ選定・分析、偽陽性・偽陰性、アラート疲労、 SOAR の自動対応に伴うリスク、運用に必要な人材・継続的な調整に関する実践ガイダンス。 Australian Cyber Security Centre
- NIST SP 800-61 Rev. 3, “Incident Response Recommendations and Considerations for Cybersecurity Risk Management: A CSF 2.0 Community Profile” (2025 年 4 月 3 日) — インシデント対応を組織全体のサイバーセキュリティリスクマネジメントに組み込むための推奨事項。 NIST CSRC
本記事は IDS/IPS や AI を活用した監視製品の価値を否定するものではありません。各製品の検知範囲・対応方式は、製品、配置、設定、監視対象によって異なります。導入時には、実際の構成と運用条件を確認してください。